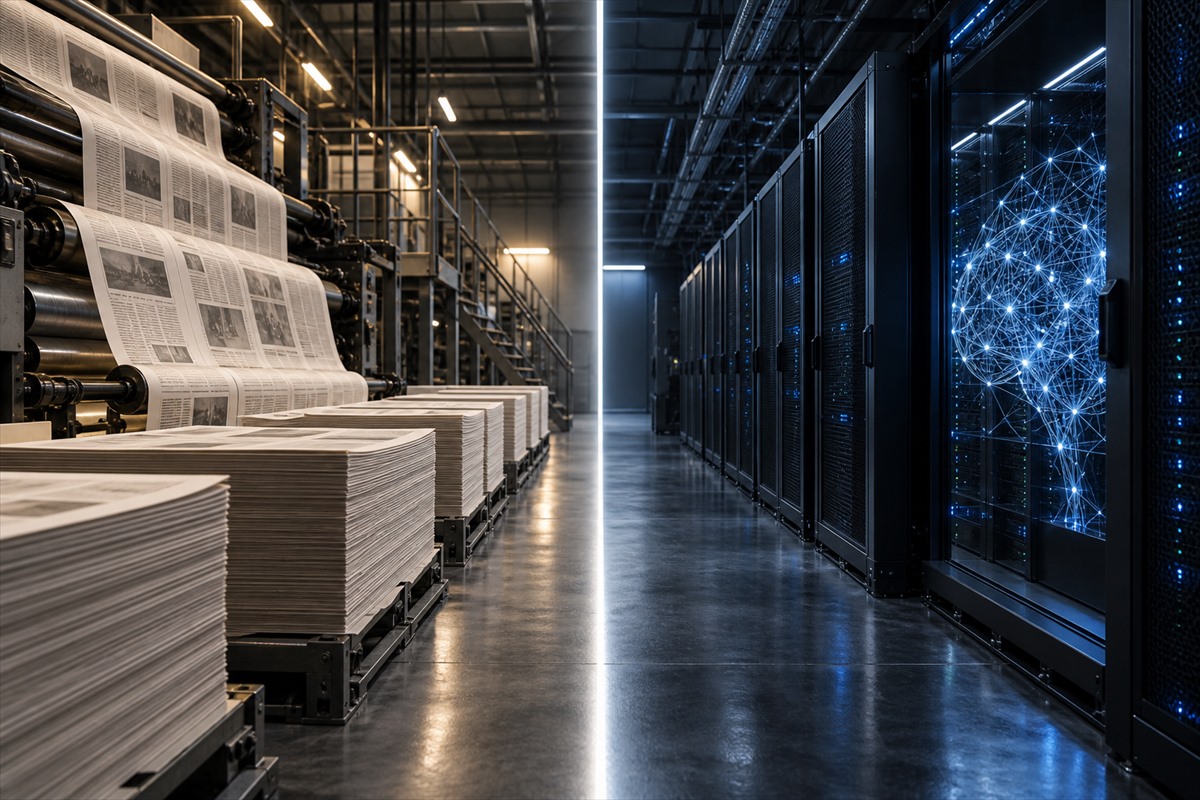
生成AIは、インターネット上の記事や書籍を許可なく学習に使ってもいいのか。
AI時代の著作権をめぐる大きな問いが、再び司法判断の局面に入った。
米紙ニューヨーク・タイムズ(NYT)などとOpenAI、Microsoftが争う著作権訴訟で、双方が2026年9月4日、略式判決を求める申し立てを行った。
略式判決とは、本格的な事実審理を行う裁判に進む前に、重要な事実関係について争いがないとして、裁判官に法律上の判断を求める手続きだ。
争点の中心にあるのは、AIモデルを開発するために著作物をコピーして学習させる行為が、米著作権法の「フェアユース」に当たるのかという問題だ。
この裁判の行方はOpenAIとNYTだけの問題ではない。
AI企業がこれまで行ってきた大規模な学習の法的根拠と、新聞社や出版社、著者が持つコンテンツの経済的価値。その境界線が問われている。
NYTとOpenAI、何を争っているのか
NYTがOpenAIとMicrosoftを提訴したのは2023年12月だった。
NYT側は、自社が長年にわたり多額の費用を投じて制作してきた記事が、許諾や対価なしにAIモデルの開発に利用されたと主張している。
問題は単に「コピーしたかどうか」ではない。
NYT側は、OpenAIなどのAIサービスが記事の内容を利用して回答を生成し、結果としてニュースや情報を得る手段として出版社と競合する存在になっていることも問題視している。
つまり、AIが記事を学習してまったく別のものを作っているのか。
それとも、出版社が作ったコンテンツを利用して、その市場を代替するサービスを作っているのか。
ここが大きな争点になる。
一方、OpenAIはAI学習を「高度に変容的な利用」だと主張する。
モデルは記事をそのまま保存して読者に再販売するためではなく、大量のデータから言語や情報のパターンを学び、新しい出力を生成するために利用しているという考え方だ。
米国のフェアユース判断では、元の著作物とは異なる目的や性質を持つ「transformative(変容的)」な利用であるかが重要な要素になる。
OpenAI側とNYT側は、まさにこの点で正面からぶつかっている。
「AI学習はフェアユース」という判決はすでに出ている
今回の裁判を理解するうえで重要なのが、2025年にカリフォルニア州の連邦裁判所で相次いだ二つの判断だ。
一つは、著者らがAnthropicを訴えた「Bartz v. Anthropic」。
もう一つは、著者らがMetaを訴えた「Kadrey v. Meta」だ。
いずれの裁判でも、AIモデルを訓練するために著作物を利用することについて、変容性の高さを認め、フェアユースとする判断が示された。
これだけを見ると、「AI学習は米国ではフェアユースで決着した」と思えるかもしれない。
しかし、話はそれほど単純ではない。
Anthropicの裁判では、モデルの学習そのものとは別に、海賊版サイトなどから入手した大量の書籍を保存した行為が問題となった。
つまり、
「AIを学習させること」
と、
「学習データをどう入手したか」
は別の問題として扱われ得る。
さらにMetaの裁判でも、裁判所はあらゆるAI学習を無条件に合法と認定したわけではない。
著作物を利用して作ったAIが、元の作品が存在する市場をどの程度損なうのか。
フェアユースを判断する際の「市場への影響」は、依然として重要な論点として残っている。
米司法省までOpenAI側に立った
今回の訴訟をさらに大きな問題にしているのが、米政府の介入だ。
米司法省は9月1日、ニューヨークの連邦裁判所に意見書を提出し、AIモデルの学習に著作物を利用することについてOpenAI側のフェアユース主張を支持した。
司法省は、AI開発による創造的・科学的な利益を重視するだけでなく、米国がAI分野で世界的な競争力を維持することを国家的な利益として位置づけている。
ここで著作権の問題に、もう一つの軸が加わった。
「著作者の権利」と「AI企業の技術革新」だけではない。
「国家のAI競争力」だ。
著作物をAI学習に利用できる範囲を狭めれば、米国のAI開発そのものが不利になる。
米政府はそうした政策的な懸念まで裁判所に示したことになる。
ただし、司法省の意見がそのまま裁判所の判断になるわけではない。
フェアユースを決めるのは裁判所だ。
米著作権局はもっと慎重だ
一方、米政府の中でもAI学習について完全に同じ見方が確立しているわけではない。
米著作権局は2025年に公表した生成AI学習に関する報告書で、AI学習とフェアユースについて一律の結論を示していない。
AI学習には変容的な側面があり得る一方、どのような著作物を、どこから入手し、何の目的で利用し、元の作品やその市場にどのような影響を与えるのかによって判断は変わり得る。
つまり、
「AI学習だからフェアユース」
でも、
「無断で学習したから著作権侵害」
でもない。
利用の実態を見て判断するという立場だ。
ここは、AI企業にとっても出版社にとっても重要だ。
「学習」と「市場代替」が次の争点になる
NYT対OpenAIがこれまでの著者訴訟と大きく異なるのは、原告が巨大なニュースメディアであることだ。
新聞社は記事を制作する。
検索やSNSなどを通じて読者を集める。
広告や購読料によって制作費を回収する。
しかしAIが記事を学習・参照し、ユーザーがAIの回答だけで必要な情報を得られるようになれば、元の記事へアクセスしないケースが増える可能性がある。
そこで生じる問いは、
「AIが記事を学習したか」
だけではなく、
「AIが記事の市場を代替しているか」
になる。
AIモデルの内部で行われる学習が高度に変容的だとしても、その結果として生まれたサービスが出版社の市場を奪うなら、フェアユースの評価はどうなるのか。
今回の訴訟が注目される理由の一つはここにある。
「合法か違法か」の先にあるもの
そして、もう一つ見落としてはいけないことがある。
仮に米国の裁判所がAI学習を広くフェアユースと認めたとしても、それだけで出版社とAIの問題が終わるとは限らない。
法的に利用できることと、コンテンツを作り続けられる経済構造が成立することは別の問題だからだ。
AIが必要とする信頼性の高いニュース、専門情報、書籍などを誰かが継続的に制作しなければ、AIが利用する情報そのものが痩せていく。
だからこそ現在、AI企業と出版社の間では包括的なライセンス契約だけでなく、コンテンツの利用を計測して対価を支払う仕組みも模索され始めている。
著作権訴訟では、
「AIは許可なく学習できるのか」
が問われる。
その一方で市場では、
「AIがコンテンツを使うなら、どう対価を払うのか」
という別の仕組み作りが進む。
法律と市場が、同時にAI時代のコンテンツ流通ルールを作ろうとしている。
NYT対OpenAIの裁判が示すのは、単にAI学習が合法か違法かという問題ではない。
人間が作った情報をAIが大量に利用する社会で、
「創作する側の経済を、誰がどう支えるのか」
という、まだ答えの出ていない問題だ。
参照情報
- OpenAI, New York Times case tees up key test of AI training under copyright law(Reuters、2026年9月8日)
- Reporting the facts about the New York Times’ lawsuit(OpenAI、2026年9月4日更新)
- Artificial Intelligence Study(U.S. Copyright Office)
- Copyright and Artificial Intelligence, Part 3: Generative AI Training(U.S. Copyright Office、2025年5月)