新聞記事を読むのは、人間だけではなくなるのかもしれない。
日本経済新聞社が、法人向け生成AIサービス「NIKKEI KAI」で、生成AIと外部サービスを接続する標準規格「MCP(Model Context Protocol)」に対応した「NIKKEI KAI MCP」の提供を始めた。
Microsoft CopilotやChatGPT、Claudeなど、企業の利用者が普段使っている生成AIやAIエージェントから、日経が提供するビジネス情報を直接呼び出せる。
利用できるのは、日経各媒体や業界専門紙、全国の一般紙、業界レポートなど2,000万件を超える記事データに加え、企業情報、経済・産業・為替・金利など10万系列を超えるマクロ経済データだ。
これだけなら「日経がMCPに対応した」という技術ニュースにも見える。
しかし、メディアビジネスという視点から見ると、少し違った景色が見えてくる。
これまで新聞社が情報を届ける相手は、基本的には人間だった。
紙を読む人。Webサイトを訪れる人。アプリを開く人。データベースを検索するビジネスパーソン。
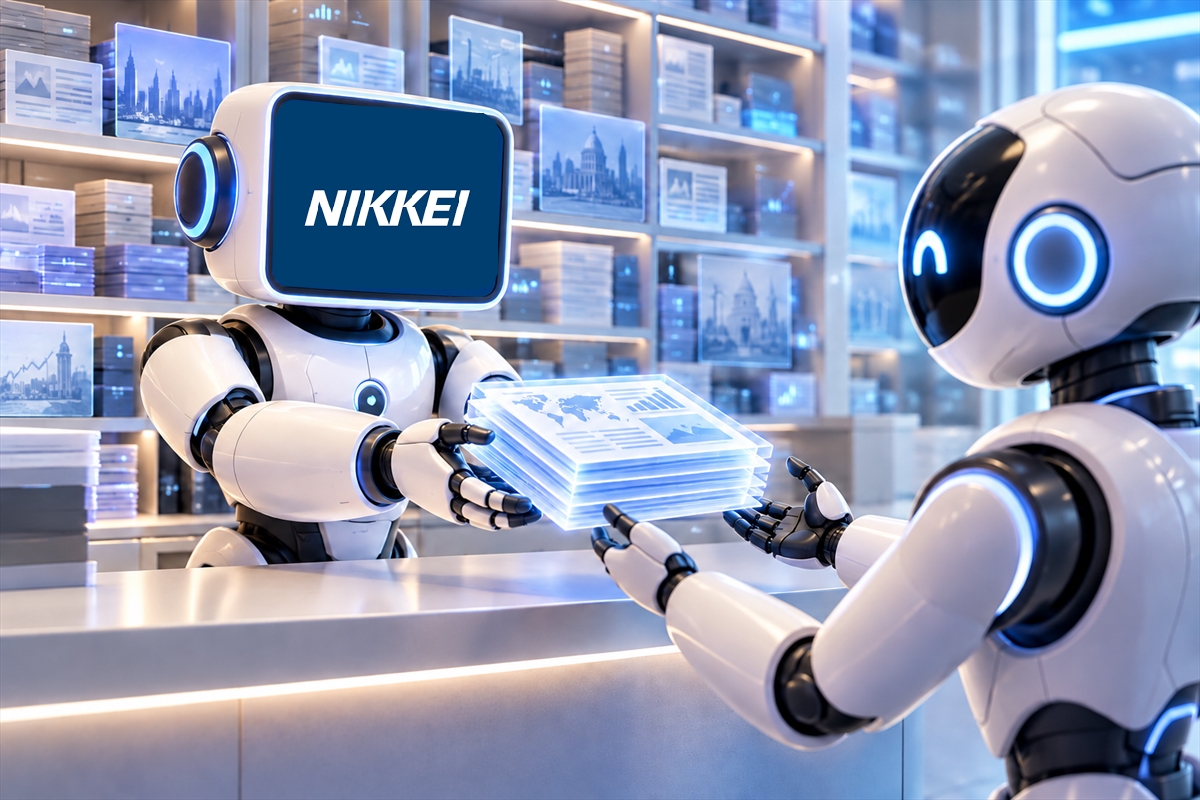
そこに、新たな情報の利用主体としてAIやAIエージェントが加わり始めた。
日経が照準を合わせ始めたのは、いわば「AI読者」である。
ChatGPTから日経を直接呼び出す
NIKKEI KAI MCPの特徴は、利用者を日経自身のWebサイトやサービス画面へ連れてくることを前提としていない点にある。
利用者はMicrosoft CopilotやChatGPT、Claudeなどで自然言語による指示を出す。
するとMCPを通じてNIKKEI KAIの情報を呼び出し、日経の記事や企業情報、経済データなどを使った調査や分析ができる。回答には出典情報も付与される。
日経自身もNIKKEI KAIについて、汎用LLMが参照できない信頼性の高い記事やビジネスデータを「AIとつなぐプラットフォーム」と位置付けている。
これは、Webメディアが長く追い続けてきた「自分たちのサイトへ読者を連れてくる」という発想とはかなり違う。
AIが記事やデータを取得し、それを分析し、別の情報と組み合わせ、最終的な回答を人間に届ける。
新聞社と読者の間にAIが入る。
ただし日経は、そのAIを排除するのではなく、正規の接続口を用意する方向を選んだ。
「勝手にAIに読ませるな」から正規ルートへ
ここには興味深い対比がある。
日経テレコンは、過去40年分の新聞・雑誌記事を中心に、企業情報や人物情報などを収録する会員制ビジネスデータベースだ。
その利用条件では、提供される情報を生成AIなどに入力したり、学習させたり、解析・加工させたりすることを原則として認めていない。
考えてみれば当然でもある。
有料で提供しているデータベースを契約者が自由にAIへ投入し、別の情報サービスとして利用できてしまえば、権利管理もビジネスモデルも成り立ちにくい。
ところがNIKKEI KAIでは、AIによる情報利用そのものが商品になった。
勝手にAIへ読ませるのではなく、日経自身が管理する情報基盤へMCPやAPIを通じて接続する。
言い換えれば、
「AIに読ませない」のではなく、「AIが読むための正規ルートを売る」。
ここにNIKKEI KAI MCPの事業的な面白さがある。
実は半世紀続いてきた情報ビジネス
もっとも、日経が記事を「読むもの」だけではなく「利用する情報」として売るようになったのは最近ではない。
1970年、日本経済新聞社は総合経済データベース「日経NEEDS」の提供を開始した。
1984年には会員制ビジネスデータベース「日経テレコン」を始めている。
インターネットが一般に普及するより前から、新聞記事や経済情報を紙面という完成品だけでなく、検索・蓄積・分析できるデータとして提供してきた。
現在の日経のデータ・情報サービスでは、利用環境に応じてファイル提供、APIによるシステム連携、MCPによる生成AI活用など複数の提供方法を用意している。
そう考えると、NIKKEI KAI MCPは日経が突然「AI企業」になろうとしている話ではない。
半世紀以上続けてきた情報ビジネスの接続先が、もう一つ増えたと見る方が自然だ。
NEEDSではデータを利用する。
テレコンでは人間が検索する。
APIでは企業のシステムが情報を呼び出す。
そしてMCPでは、AIエージェントが自然言語による指示を受けて必要な情報を取りに来る。
変わったのは、情報そのものだけではない。
情報を読む主体が変わり始めている。
メディアは「サイト」から「情報インフラ」へ
ここには、ニュースメディアにとって重要な示唆がある。
Webメディアのビジネスは長く、サイトへの訪問を前提としてきた。
検索エンジンやSNSから人を呼び込み、記事を読んでもらい、広告を表示する。あるいは、その読者を有料会員へ転換する。
ところが生成AIでは、ユーザーが情報源のWebサイトを訪れなくても答えを得られる場面が増える。
その変化をメディア側から見れば「トラフィックを奪われる」となる。
だが別の見方もできる。
人間がサイトへ来なくなるのなら、情報そのものをAIが利用できる形にして売ればいい。
NIKKEI KAI MCPが示しているのは、その可能性だ。
新聞社が「記事を掲載するWebサイト」だけではなく、
信頼できる記事やデータを、必要な相手へ必要な形式で供給する情報インフラになる。
それを突き詰めれば、「メディアのAPI化」とも呼べる。
Webサイトを捨てる話ではない
もちろん、Webサイトや電子版が不要になるという話ではない。
人間がニュースを読み、偶然情報と出会い、記者の取材や分析を一つの記事として読む体験には、データ取得とは異なる価値がある。
NIKKEI KAI自体もMCPだけではない。
ブラウザから利用するSaaSに加え、企業のAI基盤や社内システムに組み込むMCP/API連携を提供している。
重要なのは、情報の出口を一つに決めなくなったことだ。
人間にはWebサイトやSaaS。
企業システムにはAPI。
生成AIやAIエージェントにはMCP。
同じ情報資産を、利用する主体や目的に合わせて異なるインターフェースから提供する。
そう考えると、メディア企業の競争力も変わってくる。
PVだけではなく、どれだけ質の高い情報を蓄積しているか。
データがどれだけ整理され、機械から利用できる状態になっているか。
出典や権利関係をどこまで管理できているか。
そして、その情報へ安全にアクセスする接続口を持っているか。
こうした能力が、AI時代のメディア資産になる可能性がある。
次の読者は人間とは限らない
NIKKEI KAI MCPを「日経がMCPに対応した」というニュースだけで見ると、その意味を小さく捉えてしまう。
1970年のNEEDS、1984年のテレコン、APIによるデータ提供、そしてMCP。
その流れを並べると、日経が長く続けてきたことは一貫している。
情報を集め、整理し、信頼性を付与し、その時代に適した方法で利用者へ届ける。
ただ、今回は一つ大きな違いがある。
情報を取りに来る相手が、人間とは限らなくなった。
日経はNIKKEI KAIの今後について、MCP機能やAIエージェントとの連携だけでなく、「AI活用に適した日経コンテンツ」の拡充にも取り組むとしている。
これは情報の届け方だけではなく、情報を作る側にも「AIが使う」という前提が入り始める可能性を感じさせる。
生成AIやAIエージェントが人間に代わって情報を探し、比較し、読み、必要な部分を使うようになれば、メディアにとってAIは単なる検索流入を奪う競争相手ではなくなる。
情報を提供する、新しい顧客にもなり得る。
メディアはこれまで「どうすれば人間に読みに来てもらえるか」を考えてきた。
これからは、それにもう一つ問いが加わる。
AIに読まれることを前提にしたメディアは、何を売るのか。
NIKKEI KAI MCPは、その答えの一つを先に試している。
参照情報
日本経済新聞社「生成AI連携機能『NIKKEI KAI MCP』提供開始、企業の調査業務や事業企画を支援」
NIKKEI KAI MCPの提供開始、対応する生成AI・AIエージェント、2,000万件超の記事データ、10万系列超のマクロ経済データ、出典情報の付与、今後のコンテンツ拡充方針を確認。
日本経済新聞社「NIKKEI KAI」
NIKKEI KAIの位置付け、SaaS、MCP/API連携、日経の記事・ビジネスデータをAIとつなぐ提供形態を確認。
日本経済新聞社「製品とサービス|データ・情報サービス」
1970年の日経NEEDS、1984年の日経テレコンの提供開始と、日経の法人向けデータ・情報サービスの沿革を確認。
日本経済新聞社「日経テレコン(オンライン契約)の利用規約」
別途書面で許可された場合を除き、提供情報を生成AI等へ入力、学習、解析・加工させることを禁止する条件を確認。